# 递归的概念
-
直接或间接地调用自身的算法称为递归算法。用函数自身给出定义的函数称为递归函数
-
由分治法产生的子问题往往是原问题的较小模式,这就为使用递归技术提供了方便。在这种情况下,反复应用分治手段,可以使子问题与原问题类型一致而其规模却不断缩小,最终使子问题缩小到很容易直接求出其解。这自然导致递归过程的产生。
-
分治与递归像一对孪生兄弟,经常同时应用在算法设计之中,并由此产生许多高效算法。
-
优点:
结构清晰,可读性强,而且容易用数学归纳法来证明算法的正确性,因此它为设计算法、调试程序带来很大方便 -
缺点:
递归算法的运行效率较低,无论是耗费的计算时间还是占用的存储空间都比非递归算法要多。 -
在递归算法中消除递归调用,使其转化为非递归算法。
- 采用一个用户定义的栈来模拟系统的递归调用工作栈。该方法通用性强,但本质上还是递归,只不过人工做了本来由编译器做的事情,优化效果不明显。
- 用递推来实现递归函数。
- 通过变换能将一些递归转化为尾递归,从而迭代求出结果。
后两种方法在时空复杂度上均有较大改善,但其适用范围有限。
# 分治的基本思想
分治法的基本思想是将一个规模为 n 的问题分解为 k 个规模较小的子问题,这些子问题相互独立且与原问题相同,递归地解这些子问题,然后将各子问题的解合并得到原问题的解
# 分治法的适用条件
分治法所能解决的问题一般具有以下几个特征:
- 该问题的规模缩小到一定的程度就可以容易地解决;
- 该问题可以分解为若干个规模较小的相同问题,即该问题具有最优子结构性质
- 利用该问题分解出的子问题的解可以合并为该问题的解;
- 该问题所分解出的各个子问题是相互独立的,即子问题之间不包含公共的子问题。
# 代码框架
divide-and-conquer(P) | |
{ | |
if ( | P | <= n0) adhoc(P); // 解决小规模的问题 | |
divide P into smaller subinstances P1,P2,...,Pk;// 分解问题 | |
for (i=1,i<=k,i++) | |
yi=divide-and-conquer(Pi); // 递归的解各子问题 | |
return merge(y1,...,yk); // 将各子问题的解合并为原问题的解 | |
} |
# 求解递归
# 猜测法
用于验证
# 递归树法
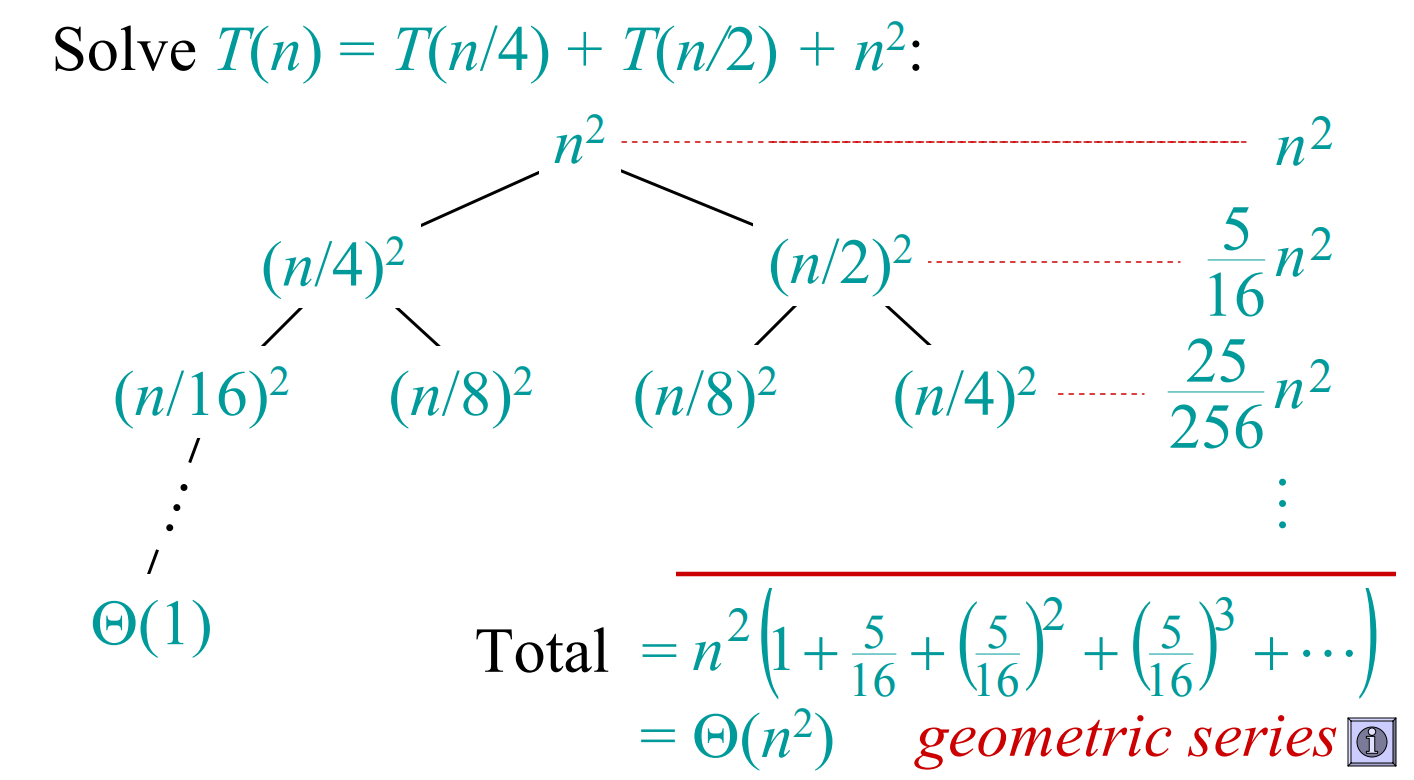
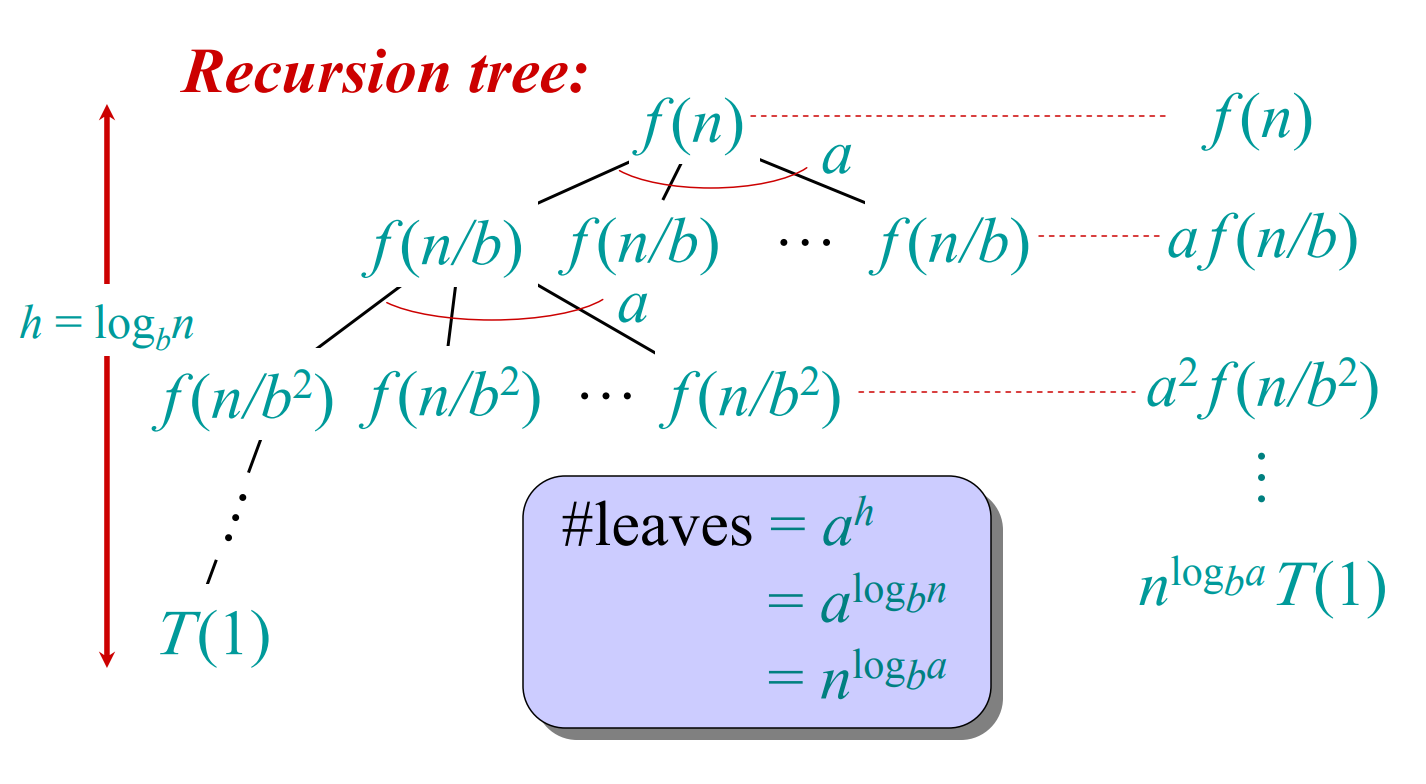
在原函数中,每进行一次分解就带来一份固定的 的开销,也就是分解每进行一层,除了叶子的开销外要额外付出 的开销,那么就可以通过统计分解数的每一层的开销,和所有叶子结点的开销来表达总开销.
# 递归树法例题
解答
每分解一层,代价为,
树高, 共有 个叶子结点,转换为,
解答
每分解一层,代价为,
树高, 每层的代价均为,
$T(n) = T (n/3) + T (2n/3) + cn\ <cnlog_{3/2}n \ =O(nlgn) $
# 主方法
要求,
:
- .
, 增长率多项式小于 - .
, 与 增长率一致 - .
.
增长率多项式大于.
满足正则条件:
# 主方法例题
解答
解答
解答
解答
不适用任何一种情况,因为
# General method(Akra-Bazzi)
当 时,用 替代, 即和主方法一致
# 根据代码判断复杂度的方法
- for /while 循环
循环体内计算时间 * 循环次数; - 嵌套循环
循环体内计算时间 * 所有循环次数; - 顺序语句
各语句计算时间相加; - if-else 语句
if 语句计算时间和 else 语句计算时间的较大者。 - 求解递归
- 赋值
# 分治算法设计与技巧重要知识点
# 二分搜索
template<class Type> | |
int BinarySearch(Type a[], const Type& x, int l, int r) | |
{ | |
while (r >= l){ | |
int m = (l+r)/2; | |
if (x == a[m]) return m; | |
if (x < a[m]) r = m-1; else l = m+1; | |
} | |
return -1; | |
} |
算法复杂度分析:
每执行一次算法的 while 循环, 待搜索数组的大小减少一半。因此,在最坏情况下,while 循环被执行了 O (logn) 次。循环体内运算需要 O (1) 时间,因此整个算法在最坏情况下的计算时间复杂性为 O (logn) 。
# 大整数乘法
请设计一个有效的算法,可以进行两个 n 位大整数的乘法运算
.
.
- .
- .
两个 XY 的复杂度都是,但考虑到 a+c,b+d 可能得到 m+1 位的结果,使问题的规模变大,故不选择第 2 种方案。
算法复杂度分析:
.
# strassen 矩阵乘法
将矩阵 A,B 和 C 中每一矩阵都分块成 4 个大小相等的子矩阵。由此可将方程 C=AB 重写为:
,
由此可得
.
为了降低时间复杂度,必须减少乘法的次数。
.
算法复杂度分析:
.
# 棋盘覆盖
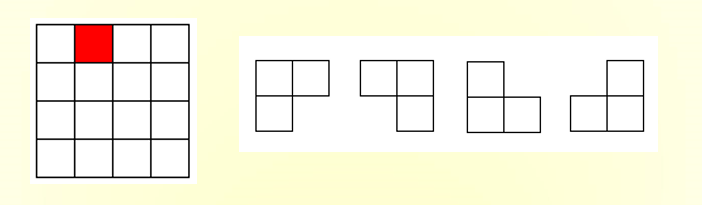
在一个 个方格组成的棋盘中,恰有一个方格与其它方格不同,称该方格为一特殊方格,且称该棋盘为一特殊棋盘。在棋盘覆盖问题中,要用图示的 4 种不同形态的 L 型骨牌覆盖给定的特殊棋盘上除特殊方格以外的所有方格,且任何 2 个 L 型骨牌不得重叠覆盖。
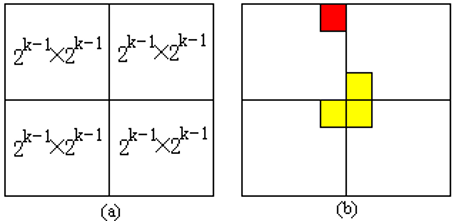
当 k>0 时,将 棋盘分割为 4 个 子棋盘 (a) 所示。
特殊方格必位于 4 个较小子棋盘之一中,其余 3 个子棋盘中无特殊方格。为了将这 3 个无特殊方格的子棋盘转化为特殊棋盘,可以用一个 L 型骨牌覆盖这 3 个较小棋盘的会合处,如 (b) 所示,从而将原问题转化为 4 个较小规模的棋盘覆盖问题。递归地使用这种分割,直至棋盘简化为棋盘 1×1。
void chessBoard(int tr, int tc, int dr, int dc, int size) | |
{ | |
if (size == 1) return; | |
int t = tile++, // L 型骨牌号 | |
s = size/2; // 分割棋盘 | |
// 覆盖左上角子棋盘 | |
if (dr < tr + s && dc < tc + s) | |
// 特殊方格在此棋盘中 | |
chessBoard(tr, tc, dr, dc, s); | |
else {// 此棋盘中无特殊方格 | |
// 用 t 号 L 型骨牌覆盖右下角 | |
board[tr + s - 1][tc + s - 1] = t; | |
// 覆盖其余方格 | |
chessBoard(tr, tc, tr+s-1, tc+s-1, s);} | |
// 覆盖右上角子棋盘 | |
if (dr < tr + s && dc >= tc + s) | |
// 特殊方格在此棋盘中 | |
chessBoard(tr, tc+s, dr, dc, s); | |
else {// 此棋盘中无特殊方格 | |
// 用 t 号 L 型骨牌覆盖左下角 | |
board[tr + s - 1][tc + s] = t; | |
// 覆盖其余方格 | |
chessBoard(tr, tc+s, tr+s-1, tc+s, s);} | |
// 覆盖左下角子棋盘 | |
if (dr >= tr + s && dc < tc + s) | |
// 特殊方格在此棋盘中 | |
chessBoard(tr+s, tc, dr, dc, s); | |
else {// 用 t 号 L 型骨牌覆盖右上角 | |
board[tr + s][tc + s - 1] = t; | |
// 覆盖其余方格 | |
chessBoard(tr+s, tc, tr+s, tc+s-1, s);} | |
// 覆盖右下角子棋盘 | |
if (dr >= tr + s && dc >= tc + s) | |
// 特殊方格在此棋盘中 | |
chessBoard(tr+s, tc+s, dr, dc, s); | |
else {// 用 t 号 L 型骨牌覆盖左上角 | |
board[tr + s][tc + s] = t; | |
// 覆盖其余方格 | |
chessBoard(tr+s, tc+s, tr+s, tc+s, s);} | |
} |
算法复杂度分析:
.
渐进意义下的最优算法
# 合并排序
将待排序元素分成大小大致相同的 2 个子集合,分别对 2 个子集合进行排序,最终将排好序的子集合合并成为所要求的排好序的集合
void MergeSort(Type a[], int left, int right) | |
{ | |
if (left<right) {// 至少有 2 个元素 | |
int i=(left+right)/2; // 取中点 | |
mergeSort(a, left, i); | |
mergeSort(a, i+1, right); | |
merge(a, b, left, i, right); // 合并到数组 b | |
copy(a, b, left, right); // 复制回数组 a | |
} | |
} |
算法复杂度分析:
.
渐进意义下的最优算法
最坏时间复杂度:O (nlogn)
平均时间复杂度:O (nlogn)
辅助空间:O (n)
# 快速排序
在快速排序中,记录的比较和交换是从两端向中间进行的,关键字较大的记录一次就能交换到后面单元,关键字较小的记录一次就能交换到前面单元,记录每次移动的距离较大,因而总的比和移动次数较少。
template<class Type> | |
void QuickSort (Type a[], int p, int r) | |
{ | |
if (p<r) { | |
int q=Partition(a,p,r); | |
QuickSort (a,p,q-1); // 对左半段排序 | |
QuickSort (a,q+1,r); // 对右半段排序 | |
} | |
} | |
template<class Type> | |
int Partition (Type a[], int p, int r) | |
{ | |
int i = p, j = r + 1; | |
Type x=a[p]; | |
// 将 & lt; x 的元素交换到左边区域 | |
// 将 > x 的元素交换到右边区域 | |
while (true) { | |
while (a[++i] <x); | |
while (a[- -j] >x); | |
if (i >= j) break; | |
Swap(a[i], a[j]); | |
} | |
a[p] = a[j]; | |
a[j] = x; | |
return j; | |
} |
快速排序算法的性能取决于划分的对称性。通过修改算法 partition,可以设计出采用随机选择策略的快速排序算法。在快速排序算法的每一步中,当数组还没有被划分时,可以在 a [p:r] 中随机选出一个元素作为划分基准,这样可以使划分基准的选择是随机的,从而可以期望划分是较对称的。
template<class Type> | |
int RandomizedPartition (Type a[], int p, int r) | |
{ | |
int i = Random(p,r); | |
Swap(a[i], a[p]); | |
return Partition (a, p, r); | |
} |
最坏时间复杂度:O (n2)
平均时间复杂度:O (nlogn)
辅助空间:O (n) 或 O (logn)
# 线性时间选择
给定线性序集中 n 个元素和一个整数 k,1≤k≤n,要求找出这 n 个元素中第 k 小的元素
template<class Type> | |
Type RandomizedSelect(Type a[],int p,int r,int k) | |
{ | |
if (p==r) return a[p]; | |
int i=RandomizedPartition(a,p,r), | |
j=i-p+1; | |
if (k<=j) return RandomizedSelect(a,p,i,k); | |
else return RandomizedSelect(a,i+1,r,k-j); | |
} |
在最坏情况下,算法 randomizedSelect 需要 计算时间
但可以证明,算法 randomizedSelect 可以在 平均时间内找出 n 个输入元素中的第 k 小元素。
如果能在线性时间内找到一个划分基准,使得按这个基准所划分出的 2 个子数组的长度都至少为原数组长度的 ε 倍 (0<ε<1 是某个正常数),那么就可以在最坏情况下用 O (n) 时间完成选择任务。
- 将 n 个输入元素划分成 个组,每组 5 个元素,只可能有一个组不是 5 个元素。用任意一种排序算法,将每组中的元素排好序,并取出每组的中位数,共 个。
- 递归调用 select 来找出这 个元素的中位数。如果 是偶数,就找它的 2 个中位数中较大的一个。以这个元素作为划分基准
Type Select(Type a[], int p, int r, int k) | |
{ | |
if (r-p<75) { | |
用某个简单排序算法对数组a[p:r]排序; | |
return a[p+k-1]; | |
}; | |
for ( int i = 0; i<=(r-p-4)/5; i++ ) | |
将a[p+5*i]至a[p+5*i+4]的第3小元素 | |
与a[p+i]交换位置; | |
// 找中位数的中位数,r-p-4 即上面所说的 n-5 | |
Type x = Select(a, p, p+(r-p-4)/5, (r-p-4)/10); | |
int i=Partition(a,p,r, x), | |
j=i-p+1; | |
if (k<=j) return Select(a,p,i,k); | |
else return Select(a,i+1,r,k-j); | |
} |
上述算法将每一组的大小定为 5,并选取 75 作为是否作递归调用的分界点。这 2 点保证了 T (n) 的递归式中 2 个自变量之和 n/5+3n/4=19n/20=εn,0<ε<1。这是使 T (n)=O (n) 的关键之处。当然,除了 5 和 75 之外,还有其他选择。
算法复杂度分析:
.
# 线性时间选择的个人理解
- 首先将整个数组每五个为一组划分,找到每一组的中位数,并将中位数交换至数组头部.
- 由于每组的中位数都在数组头部,再次调用函数求头部的 n/5 个数字当中的中位数,设为 x;
- 只要能对这几个中位数进行操作求得中位数的中位数即可,交换与否,交换的位置影响不大.
- 使用 partition 函数,数组中小于 x 的放左边,大于 x 的放右边.
- 核心思路依然是取一个值,然后分隔数组,但花费了不少时间来找到这个合适的值.
- 由于分出了 n/5 个组,在每个组求中位数的过程中,花销为 T (5)*n/5=cn.
- 求每个组的中位数的中位数过程中,花销为 T (n/5).
- 求得的这个新的中位数,他要比 (n/5-1)/2 个其他中位数要小,每个组内还有两个数比组内中位数大,那么就有 3 (n/5-1)/2 个数比 x 大,也就是, 每次分割能去掉 n/4 个数,剩下了 T (3n/4) 的复杂度.
- 由于 3n/4+n/5 小于 n, 这个算法就能降低复杂度
# 最接近点对问题
二维空间内有若干个点,寻找其中最接近的两个点
- 选取一垂直线 l:x=m 来作为分割直线。其中 m 为 S 中各点 x 坐标的中位数。由此将 S 分割为 S1 和 S2。
- 递归地在 S1 和 S2 上找出其最小距离 d1 和 d2,并设 d=min {d1,d2},S 中的最接近点对或者是 d,或者是某个 {p,q},其中 p∈P1 且 q∈P2。
- 考虑 P1 中任意一点 p,它若与 P2 中的点 q 构成最接近点对的候选者,则必有 distance (p,q)<d。满足这个条件的 P2 中的点一定落在一个 d×2d 的矩形 R 中
- 由 d 的意义可知 (d=min {d1,d2}),P2 中任何 2 个 S 中的点的距离都不小于 d。由此可以推出矩形 R 中最多只有 6 个 S 中的点。
- 因此,在分治法的合并步骤中最多只需要检查 6×n/2=3n 个候选者
证明:将矩形 R 的长为 2d 的边 3 等分,将它的长为 d 的边 2 等分,由此导出 6 个 (d/2)×(2d/3) 的矩形。若矩形 R 中有多于 6 个 S 中的点,则由鸽舍原理易知至少有一个 (d/2)×(2d/3) 的小矩形中有 2 个以上 S 中的点。设 u,v 是位于同一小矩形中的 2 个点,则,distance (u,v)< d。这与 d 的意义相矛盾。
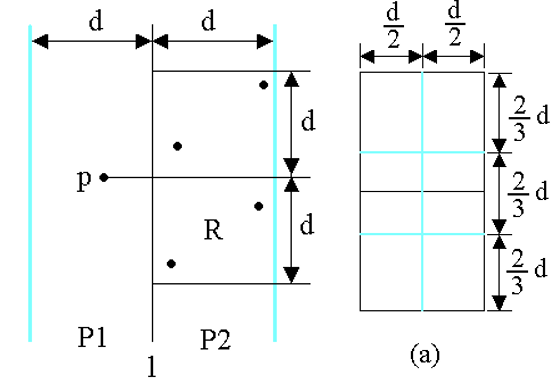
- 为了确切地知道要检查哪 6 个点,可以将 p 和 P2 中所有 S2 的点投影到垂直线 l 上。由于能与 p 点一起构成最接近点对候选者的 S2 中点一定在矩形 R 中,所以它们在直线 l 上的投影点距 p 在 l 上投影点的距离小于 d。由上面的分析可知,这种投影点最多只有 6 个。
- 因此,若将 P1 和 P2 中所有 S 中点按其 y 坐标排好序,则对 P1 中所有点,对排好序的点列作一次扫描,就可以找出所有最接近点对的候选者。对 P1 中每一点最多只要检查 P2 中排好序的相继 6 个点。
double cpair2(S) | |
{ | |
n=|S|; | |
if (n < 2) return ; | |
1、m=S中各点x间坐标的中位数; | |
构造S1和S2; | |
//S1={p∈S|x(p)<=m}, | |
S2={p∈S|x(p)>m} | |
2、d1=cpair2(S1); | |
d2=cpair2(S2); | |
3、dm=min(d1,d2); | |
4、设P1是S1中距垂直分割线l的距离在dm之内的所有点组成的集合; | |
P2是S2中距分割线l的距离在dm之内所有点组成的集合; | |
将P1和P2中点依其y坐标值排序; | |
并设X和Y是相应的已排好序的点列; | |
5、通过扫描X以及对于X中每个点检查Y中与其距离在dm之内的所有点(最多6个)可以完成合并; | |
当X中的扫描指针逐次向上移动时,Y中的扫描指针可在宽为2dm的区间内移动; | |
设dl是按这种扫描方式找到的点对间的最小距离; | |
6、d=min(dm,dl); | |
return d; | |
} |
算法复杂度分析:
.
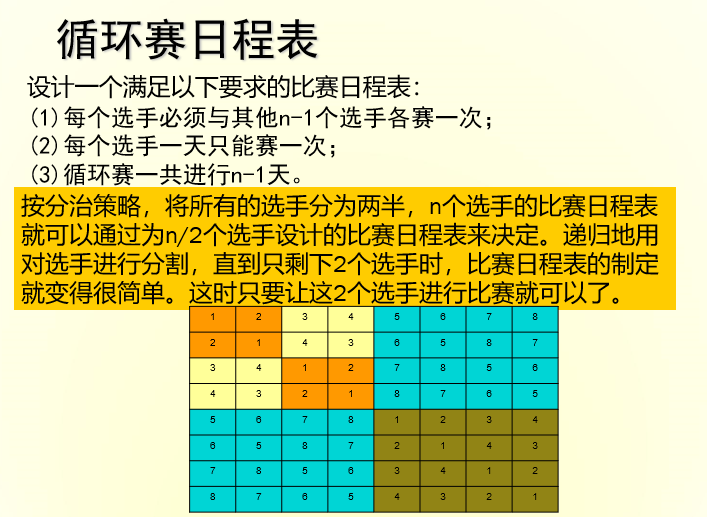
# 循环赛程表